微信公众号
手机端

搜索




微信扫一扫:分享

微信里点“发现”,扫一下
二维码便可将本文分享至朋友圈

编译/VR陀螺
11月10日,Google DeepMind正式发布新一代视觉语言动作模型Gemini Robotics 2.5,提升机器人在复杂环境下的灵巧操作、任务执行和安全控制能力。
据谷歌介绍,Gemini Robotics 2.5已在超过200项任务中接受测试,涵盖使用夹具夹取食物、系礼物蝴蝶结、液体移取等精细操作。与上一代模型相比,其在不同任务中的成功率提高30%至100%,任务完成速度提升20%至30%,尤其强化了柔性物体处理、多步骤操作及复杂工具使用能力。
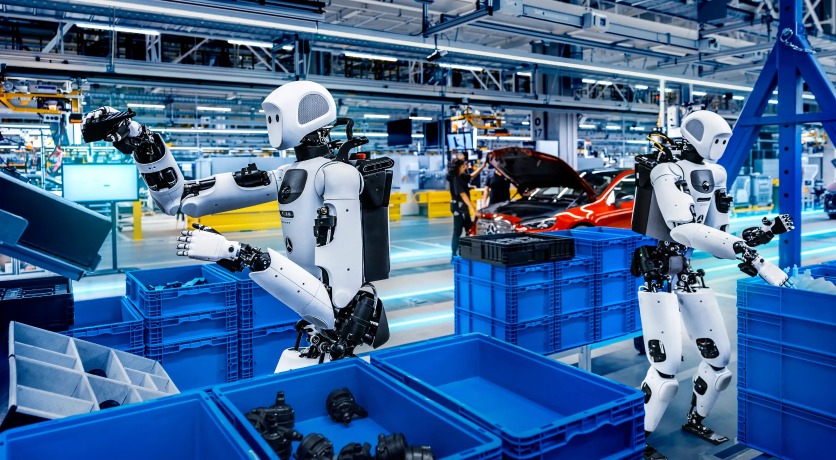
在工业应用方面,谷歌与Apptronik、奔驰合作,在匈牙利凯奇凯梅特和德国辛德尔芬根的汽车生产线开展概念验证。搭载Gemini Robotics 2.5的Apollo 2人形机器人能够自主抓取金属零部件,并按照生产要求完成分拣、排序和装箱。
谷歌披露,机器人在上述零部件配套分拣任务中的成功率达到96%。其中,Gemini Robotics ER负责理解任务与多步骤规划,Gemini Robotics 2.5则控制机械臂及灵巧手执行动作,并根据现场变化进行调整。
与此同时,谷歌还强化了模型的物理安全能力。官方测试显示,新模型在障碍物及人员附近的安全任务完成表现有所提升,并推出面向机器人安全指令攻击的开源评测基准ASIMOV-Jailbreak。此外,Gemini 4 Argon还被用于生成仿真训练场景,辅助机器人学习新技能。
投稿/爆料:tougao@youxituoluo.com
稿件/商务合作: 林南(微信 19250561593)
加入行业交流群:林南(微信 19250561593)
数字科技产业资讯与服务平台
下载「陀螺科技」APP,获取前沿深度数字科技产业讯息